单表到两千万行,分区、冷热分离、分表到底选哪个
2026-11-05
128
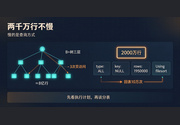
前阵子见过一个设备巡检的库,工单表跑了三年,2200 万行。列表页原来两百毫秒,后来点一次要等七八秒,客户催着问是不是该分表了。我先让运维把慢查询日志打开,三天下来排第一的那条 SQL 只查最近一个月、按状态过滤,执行计划里 type 是 ALL,status 上根本没有索引。补了一个联合索引,页面回到两百毫秒以内,分表的事暂时不用提。 这类判断每年都要做好几次。数据量确实在涨,但到两千万行只是个数字,它本身不构成必须拆表的理由。真正要回答的是三个问题,慢在什么地方、增长有多快、拆开之后查询和运维能不能接得住。一、两千万行本身不慢,慢的是查询方式 InnoDB 的索引是一棵 B+ 树,页大小 16KB。主键是 bigint,一条索引记录差不多 20 字节,加上页内指针,一个叶子页能放六百多条;上层非叶子页只存键值和页号,一个页能放一千多条。三层算下来,1170 × 1170 × 630,量级在八亿行以上。也就是说 2000 万行的表,走主键或二级索引仍然是三次页访问,和几百万行的表没有本质区别。 所以看到列表页慢,先别把账算在行数上。打开慢查询,拿 EXPLAIN 看四列就够,type 是不是 ALL 或 index,key 是不是 NULL,rows 估算多少,Extra 里有没有 Using filesort、Using temporary。一条按时间范围加状态过滤的查询,如果 type 是 ALL、rows 接近全表,问题在索引不在数据量。 真正容易被忽略的是回表。二级索引只存索引列加主键,查询要的字段不在索引里,每条记录都要回主键树再取一次。查十万行就是十万次回表,缓冲池命中不了就是十万次随机 IO,比全表顺序扫还慢。把列表要用的字段做成覆盖索引,或者干脆把大字段挪到扩展表,效果往往比分表明显。 深分页也是老问题。LIMIT 100000, 20 这种写法,MySQL 要先取出十万零二十行再扔掉前十万行,越往后翻越慢。改成延迟关联,先用覆盖索引拿到主键,再回表取二十条,代价从十万行降到二十行。SELECT w.id, w.title, w.status, w.created_atFROM work_order wINNER JOIN (SELECT id FROM work_orderWHERE tenant_id = 1024 AND sta

 在线
 电话
 微信
 需求
 TOP