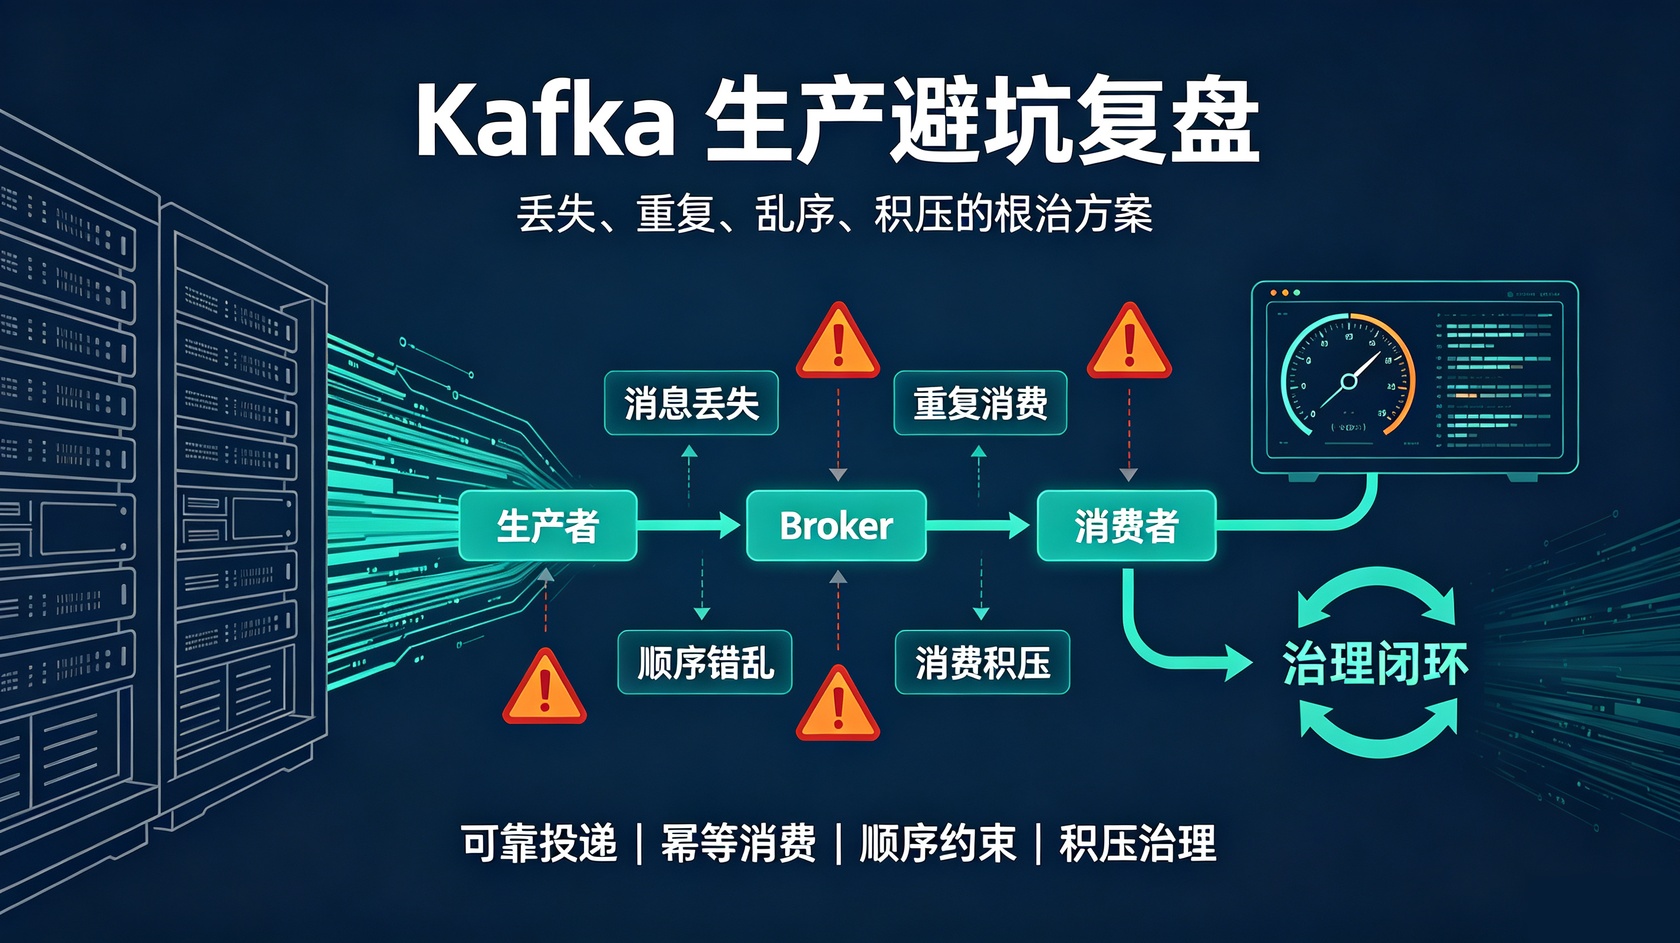
Kafka 凭借高吞吐、低延迟、天然分区的能力,成为企业构建异步解耦、削峰填谷、日志采集、事件总线的首选。很多团队在测试环境跑通 Demo 就直接上线,结果生产环境很快暴露问题:消费端偶尔收不到消息、同一个消息被处理多次、订单通知顺序颠倒、高峰期消费积压持续增长,线上故障频发。
很多人把责任归咎于 Kafka 本身不稳定,实际上绝大多数问题源于对 Kafka 语义边界理解不清晰,以及投递、消费链路上的配置与设计存在缺陷。Kafka 的"高吞吐"与"强一致"之间存在取舍,只有把可靠投递、幂等消费、顺序约束和积压治理做到位,才能真正发挥它的价值。
一、Kafka 生产高频踩坑场景
1. 消息丢失,排查才发现关键数据缺失
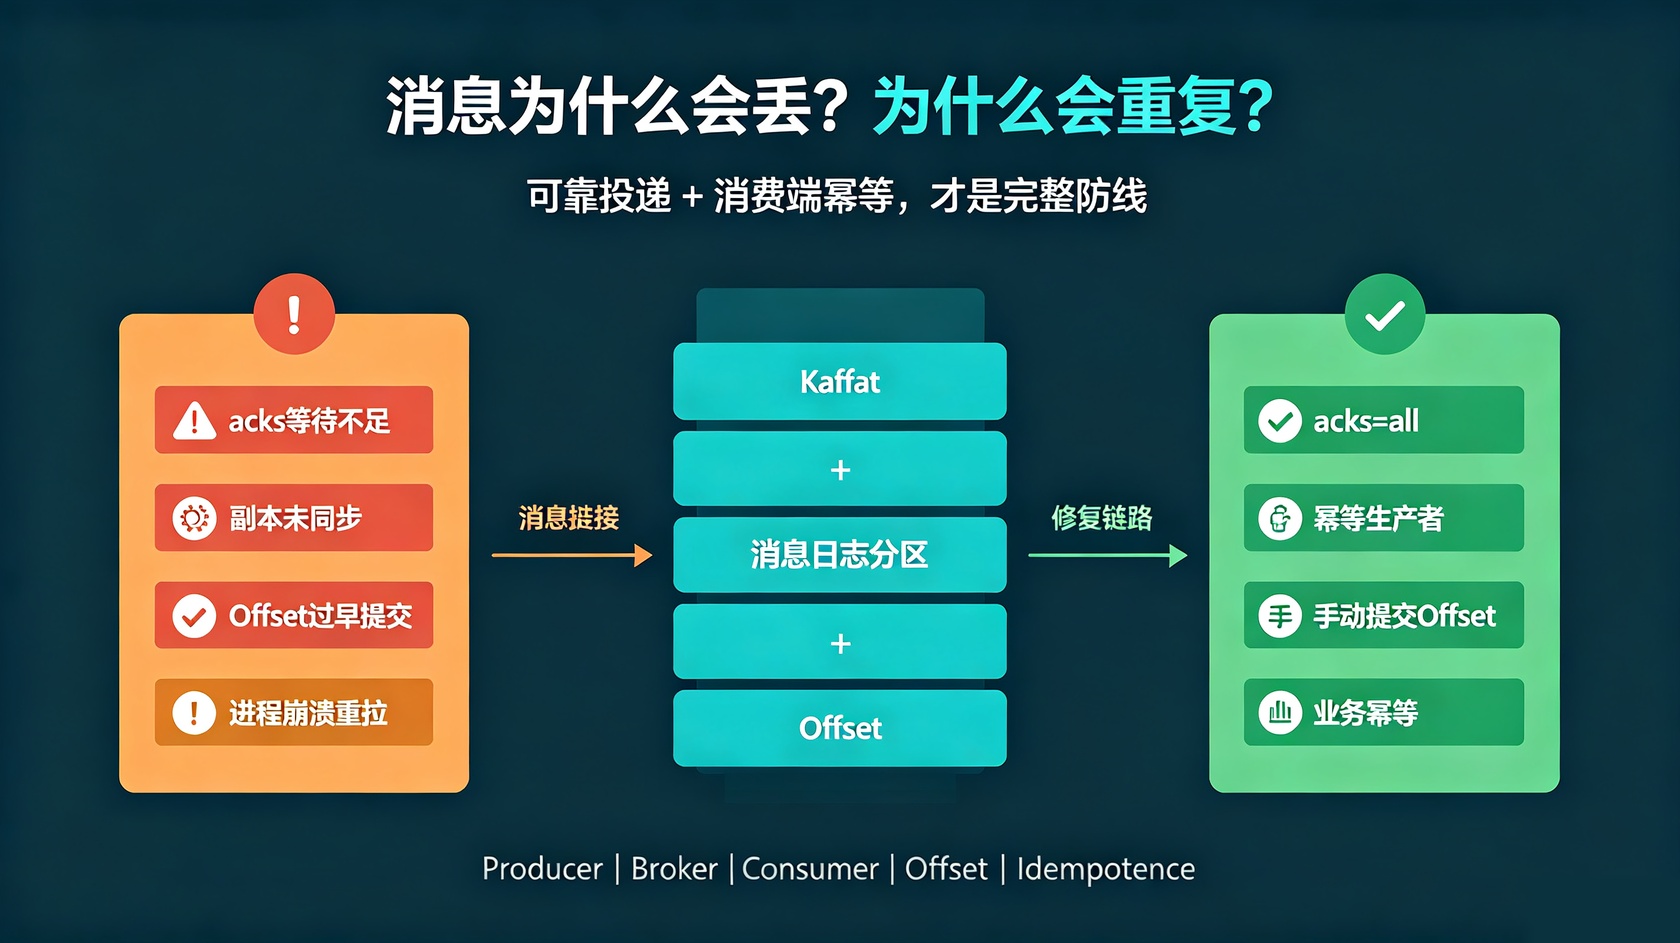
生产中最严重的问题是消息静默丢失。常见诱因有三个:生产者发送时未开启 acks 等待确认,异步发送模式下消息未刷盘就返回成功;broker 端未配置副本因子,或副本同步未完成就 ack;消费端提交 offset 过早,消息处理失败后 offset 已提交,重启后直接跳过失败消息。数据链路任一环节存在缺陷,都会造成消息永久丢失。
2. 重复消费,业务数据被重复处理
消费端在处理完消息、提交 offset 之间,进程崩溃、网络抖动或触发重平衡,未提交的 offset 会导致消息被重新拉取。此时如果业务逻辑不具备幂等性,就会出现重复下单、重复扣款、重复发送通知等严重事故。重复消费在 Kafka 中是常态而非异常,只能靠消费端幂等兜底。
3. 顺序错乱,业务状态被颠倒执行
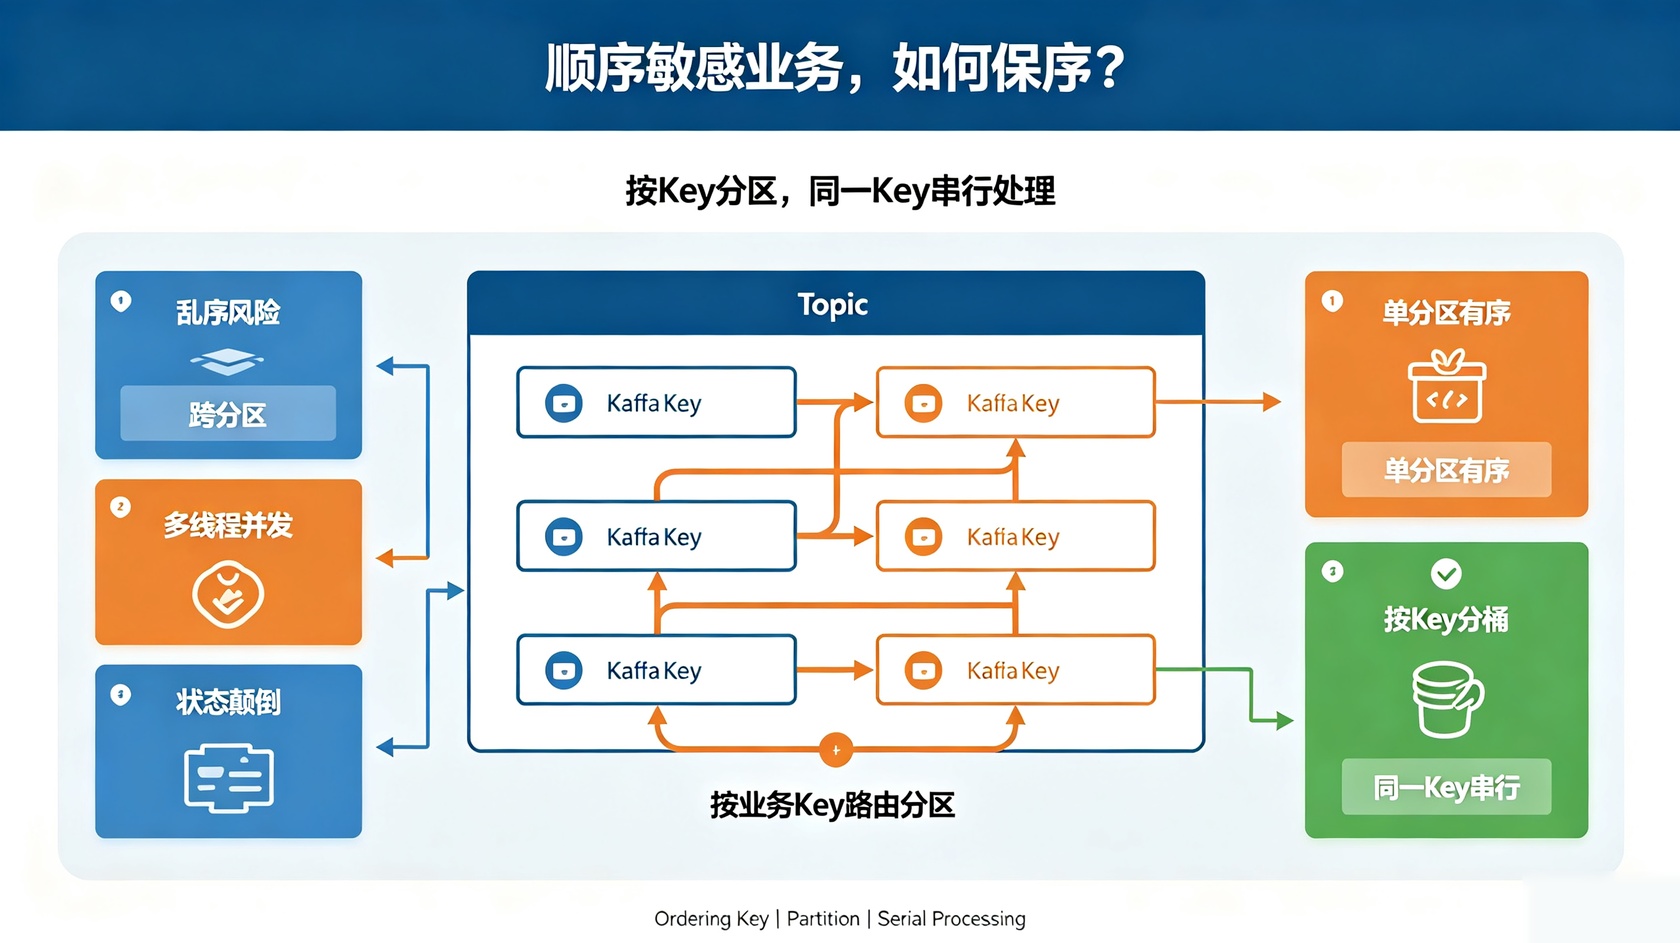
同一业务对象的多条消息本应按顺序处理,但 Kafka 只保证单个分区内有序,跨分区、多线程并发消费都会打乱顺序。例如订单的"创建-支付-发货"消息一旦顺序颠倒,就会造成状态回退或校验失败。盲目开启多分区、提高并发,反而破坏了原有的顺序保证。
4. 消费积压,处理速度跟不上生产速度
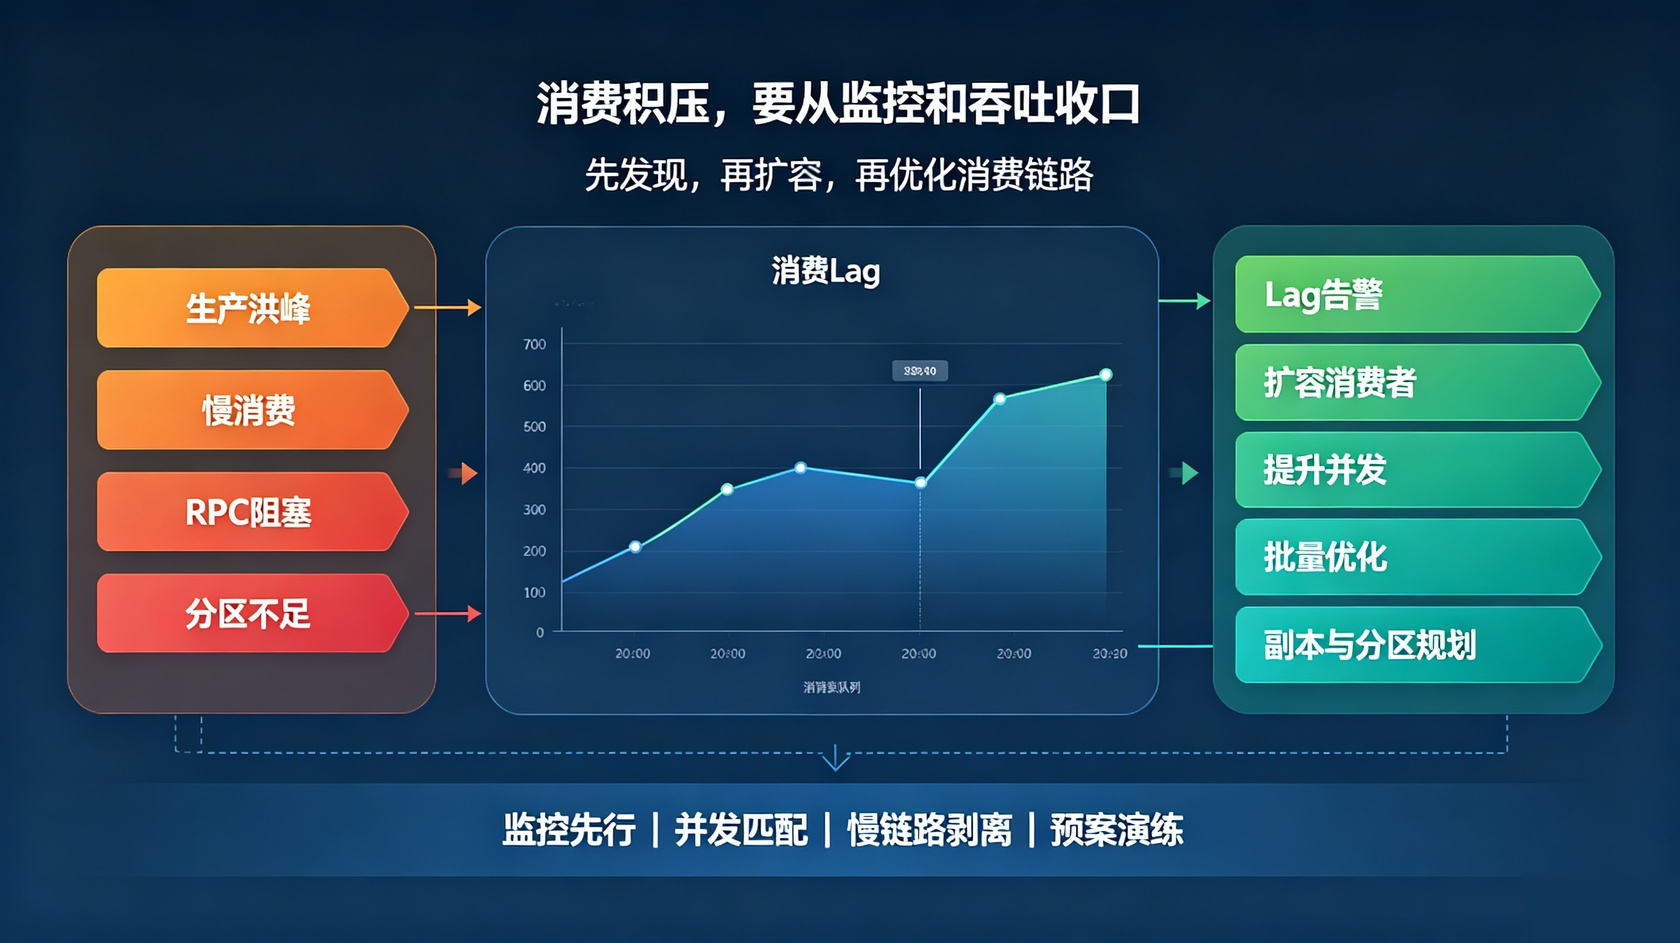
高峰期生产者写入速度远超消费者处理能力,消息在 topic 中持续堆积,消费延迟从秒级膨胀到小时级。常见诱因包括消费逻辑中包含慢查询、外部 RPC 调用、批量处理单条执行、分区数小于消费者并发数,以及消费者异常未报警被忽略。积压不治理,会持续拉高消息滞后,最终拖垮下游业务。
二、生产级 Kafka 可靠投递方案
1. 生产者端配置可靠参数
将 acks 设置为 all,等待所有副本同步完成再确认写入;retries 调大并开启 enable.idempotence 幂等写入,避免网络重试导致的重复消息;合理设置 batch.size 与 linger.ms,在吞吐与延迟之间找到平衡。生产环境强烈建议开启幂等生产者,从源头降低重复风险。
2. 消费端手动提交 offset
关闭自动提交 enable.auto.commit,改为业务处理成功后再手动提交 offset,且采用先处理、后提交、再提交下一批的语义。消息处理失败时,根据业务类型决定重试、死信或本地重放,避免失败消息被无脑跳过。
3. 处理结果幂等化
为每条消息携带全局唯一业务 ID,消费端利用数据库唯一约束、Redis 去重或状态机校验,保证同一消息被重复消费时只生效一次。幂等是 Kafka 重复消费的唯一可靠兜底手段,必须在业务层提前设计。
三、消息顺序保证实战
1. 单一分区保序
对顺序敏感的业务,将同一业务对象(如同一订单、同一用户)的所有消息路由到同一个分区。生产者通过业务 key 计算分区,消费者单线程或按 key 分桶消费,即可在分区内严格保证顺序。
2. 减少并发扰动
顺序敏感场景避免对同一 key 开启多线程并行消费;若必须提高吞吐,采用按 key 加锁或按 key 分桶的方式,保证同一 key 内的消息串行处理,不同 key 之间并行。
3. 明确顺序边界
Kafka 只保证单分区顺序,跨分区、跨 topic 的全局顺序在分布式场景下难以实现。设计阶段应明确顺序约束的作用域,避免对全局强一致顺序提出不切实际的要求。
四、消费积压治理与调优
1. 积压监测与告警
监控每个 consumer group 的 lag 指标,设置滞后阈值告警,一旦超过阈值立即触发排查。积压是持续性问题,必须用监控第一时间发现,而不是等用户投诉后才响应。
2. 提升消费并行度
合理设置分区数与消费者实例数,使消费者并发度匹配分区数;优化消费逻辑,将慢查询、外部 RPC 从消费主链路中剥离,采用异步化、批量处理降低单条消息耗时,从根本提升消费吞吐。
3. 临时扩容与应急处理
积压爆发时,优先扩容消费者实例、临时提升分区数,或对积压 topic 启动独立的高吞吐消费任务。同时排查是慢消费者还是生产洪峰导致,针对性扩容,避免盲目加分区破坏顺序约束。
五、Kafka 集群参数与运维建议
生产环境建议 topic 设置合理的副本因子(通常 3)与 min.insync.replicas,兼顾可用性与一致性;broker 合理配置磁盘、内存、日志保留策略与分区数量,避免单分区数据量过大。建立消息链路全链路追踪,记录消息的产生、投递、消费与失败补偿,出现故障时能快速定位到具体环节。定期演练消费失败、broker 宕机、积压爆发等异常场景,确保应急预案可执行。
六、总结
Kafka 生产故障,绝大多数不是中间件本身的问题,而是对可靠投递、幂等消费、顺序边界和积压治理理解不到位。核心原则可以归纳为:生产者开启幂等与全副本确认,消费端手动提交 offset 并做好幂等兜底,顺序敏感业务按 key 分区保序,积压问题靠监控先行、并发治理。把这几条落地,Kafka 才能从"能跑"变成真正"可靠",支撑业务平稳运行。

 在线
 电话
 微信
 需求
 TOP