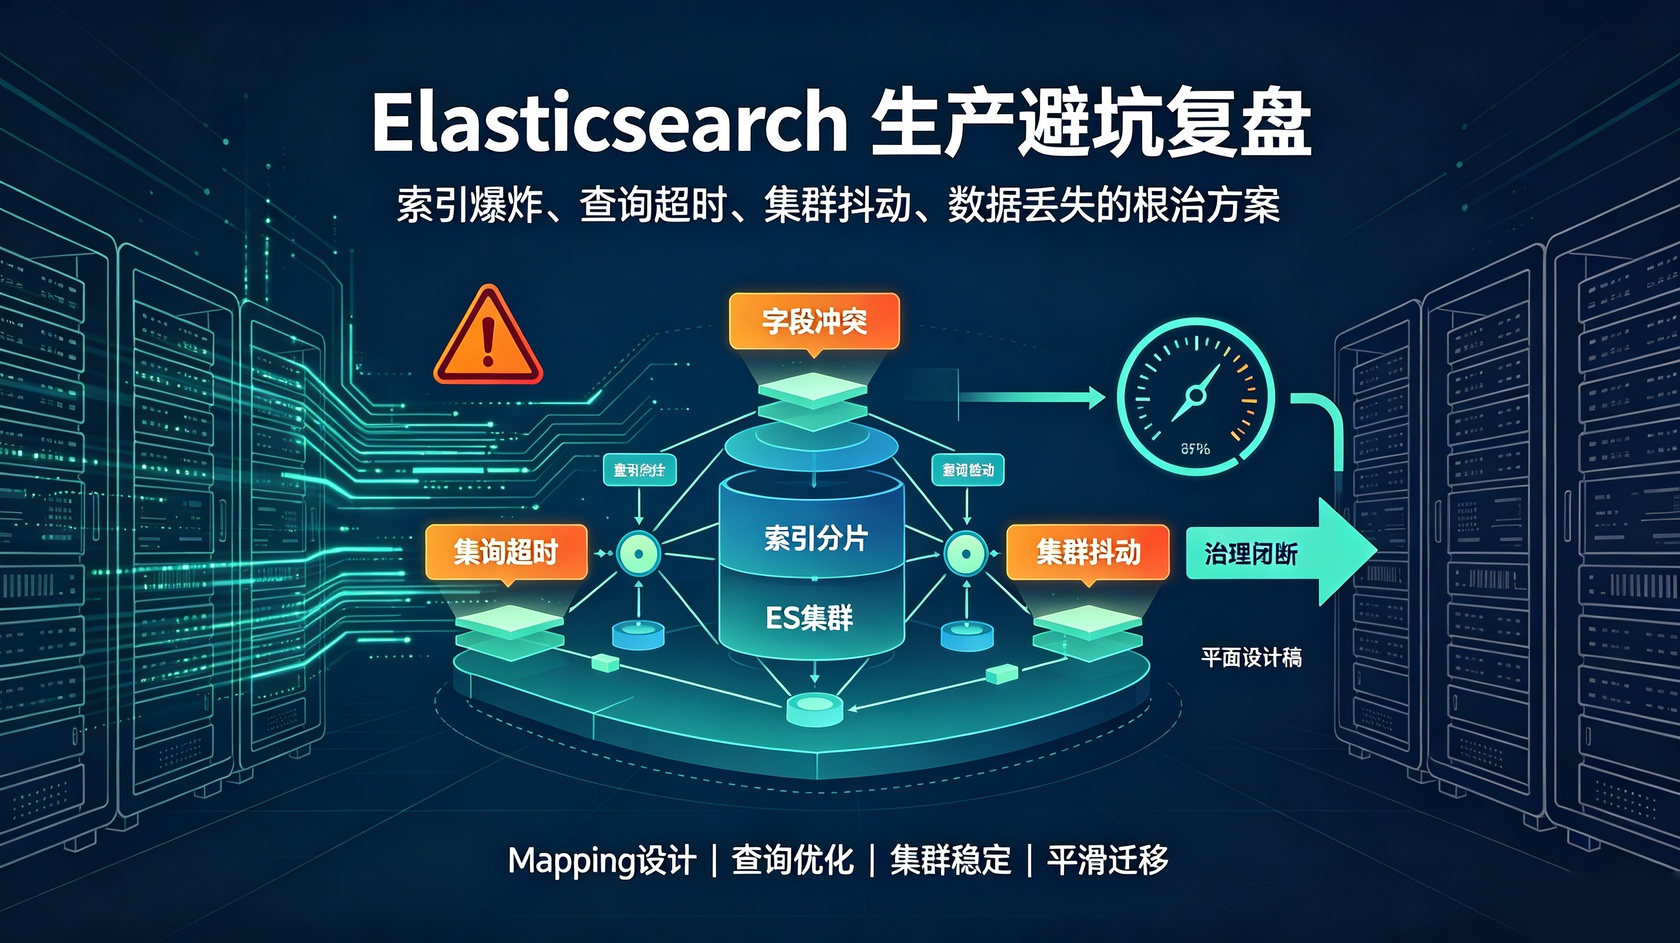
Elasticsearch 凭借强大的全文检索、聚合分析与水平扩展能力,成为企业构建搜索、日志平台、业务查询的热门选择。很多团队在测试环境简单建几个索引就能跑通,直接搬上生产,结果很快暴露问题:字段类型冲突导致索引创建失败、查询从毫秒级涨到几十秒、节点内存抖动引发集群变红、重建索引期间业务数据查不到甚至丢失。
很多人把问题归咎于 Elasticsearch 资源消耗大、稳定性差,实际上绝大多数源于对索引模型、Mapping 映射和集群运行机制理解不深,以及上线前的设计缺陷。Elasticsearch 的核心价值建立在合理的索引与查询设计之上,只有把 Mapping 规划、查询优化和集群治理做扎实,才能让它稳定支撑生产业务。
一、Elasticsearch 生产高频踩坑场景
1. 字段类型冲突,索引创建直接失败
同一字段在不同批次数据中出现不同类型,或后期新增字段类型与已有 Mapping 不一致,Elasticsearch 会直接拒绝写入。例如某字段前期是文本,后期传入数字,索引创建或文档写入立即报错。缺乏规范的字段治理与索引模板,是这类问题频发的根源。
错误示例(动态映射隐患)
// 首次写入:order_num 被识别为text类型
POST /business-order/_doc
{
  "order_num": "OD20260922001",
  "user_id": 10086
}

// 二次写入:order_num传入数字,直接报错映射冲突
POST /business-order/_doc
{
  "order_num": 20260922002,
  "user_id": 10087
}
2. 查询性能劣化,从毫秒涨到几十秒
深分页、全字段通配、非索引字段过滤、大量聚合未加合理约束,都会拖垮查询性能。深分页(from 很大)需要扫描并排序大量文档,聚合桶过多导致内存暴涨,未索引字段无法高效过滤被迫全表扫描,最终接口超时、资源耗尽。
错误示例(深分页+全通配高危查询)
// from超大深分页 + 全字段通配,千万级数据直接超时
GET /business-order/_search
{
  "from": 10000,
  "size": 20,
  "query": {
    "wildcard": {
      "*": "2026*"
    }
  }
}
3. 分片与副本配置不当,集群抖动、数据丢失
分片数设置过多或过少、副本数不足、节点内存配置不合理,会造成数据分布不均、单点故障无冗余、节点 OOM 抖动。主分片或副本缺失时集群变红,写入失败、查询返回不完整,严重时数据永久丢失。生产新手常出现单节点部署、副本数为0、分片随意配置的低级错误。
4. 重建索引期间业务中断、数据不一致
业务字段频繁变化时,直接修改现有 Mapping 往往不被允许,需要重建索引。很多团队采用停机重建或双写不一致的方式,导致业务查询中断、新旧索引数据不一致,切换过程又缺验证,上线后查询结果错乱。
二、生产级索引与 Mapping 设计
1. 提前规划索引结构与字段类型
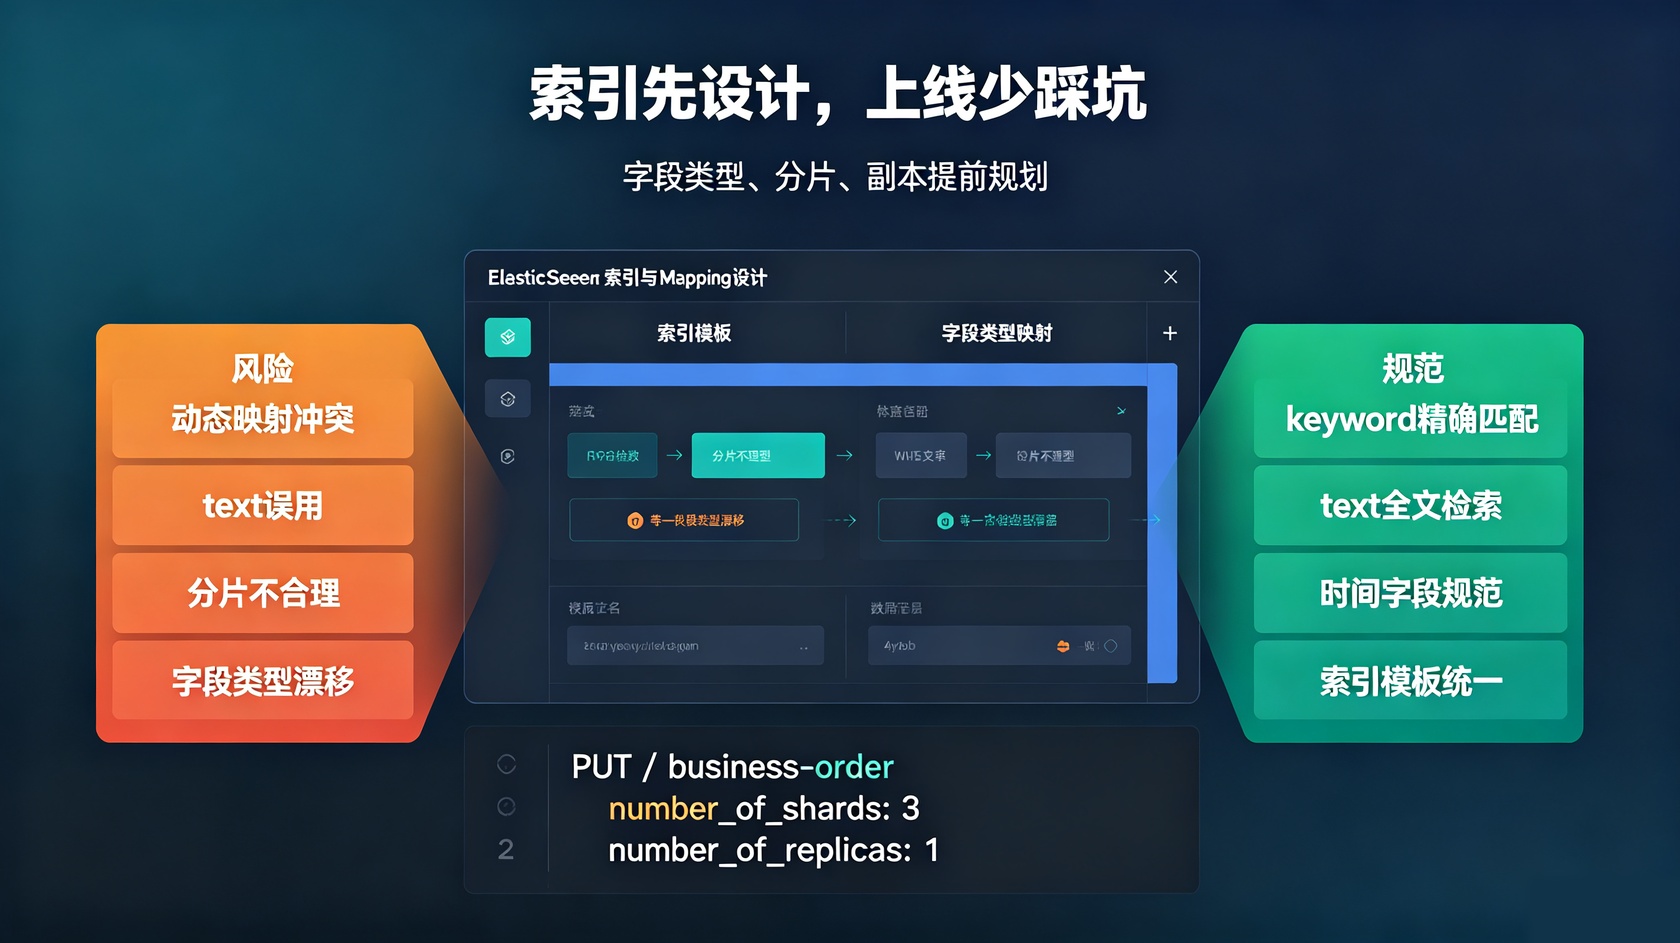
上线前明确索引的字段清单、字段类型与是否需要分词、聚合、排序,建立规范的索引模板与命名规范。区分 keyword(精确匹配)与 text(全文检索),避免对无需分词的字段误建 text 造成存储膨胀和查询变慢。
生产标准Mapping模板(可直接复用)
PUT /business-order
{
  "settings": {
    "number_of_shards": 3,
    "number_of_replicas": 1
  },
  "mappings": {
    "properties": {
      "order_id": {"type": "keyword"},
      "order_num": {"type": "keyword"},
      "user_id": {"type": "long"},
      "order_title": {"type": "text", "analyzer": "ik_max_word"},
      "order_amount": {"type": "double"},
      "create_time": {"type": "date", "format": "yyyy-MM-dd HH:mm:ss"}
    }
  }
}
2. 按业务与时间合理分片
根据数据量和查询模式选择分片数,单分片数据量控制在合理范围,避免分片过多造成元数据膨胀、分片过少造成热点。时序类数据按时间建索引,便于生命周期管理与冷热分离。
3. 善用索引模板与生命周期管理
使用索引模板统一新索引的 Mapping、分片与副本设置;对日志类时序数据配置 ILM 生命周期管理,自动完成滚动、冷热迁移与过期删除,从源头控制索引数量与存储成本。
索引模板配置脚本
PUT /_index_template/order-template
{
  "index_patterns": ["business-order-*"],
  "priority": 100,
  "template": {
    "settings": {
      "number_of_shards": 3,
      "number_of_replicas": 1,
      "refresh_interval": "1s"
    },
    "mappings": {
      "properties": {
        "order_id": {"type": "keyword"},
        "create_time": {"type": "date"}
      }
    }
  }
}
三、查询性能优化方案
1. 避免深分页,改用游标或滚动
业务分页尽量控制深度,避免大 from 深分页;需要遍历大量数据的场景改用 search_after 或 scroll 游标,减少排序与内存开销,避免查询超时。
最优方案:search_after 深度分页(无性能瓶颈)
// 首次查询,获取最后一条排序值
GET /business-order/_search
{
  "size": 20,
  "sort": [{"create_time": "desc"}, {"order_id": "desc"}]
}

// 后续分页,通过上一页最后一条数据游标查询
GET /business-order/_search
{
  "size": 20,
  "search_after": [1726923456000, "OD20260922001"],
  "sort": [{"create_time": "desc"}, {"order_id": "desc"}]
}
2. 精确控制查询与聚合范围
过滤条件尽量使用已索引的字段并配合缓存,减少全表扫描;聚合设置合理的 size 上限,避免产生过多桶;大聚合结果采用采样或前置过滤,降低内存消耗。
规范聚合查询(限制桶数量、前置过滤)
GET /business-order/_search
{
  "size": 0,
  "query": {
    "range": {
      "create_time": {
        "gte": "2026-09-01 00:00:00",
        "lte": "2026-09-22 23:59:59"
      }
    }
  },
  "aggs": {
    "order_stat": {
      "terms": {
        "field": "order_status",
        "size": 10 // 限制聚合桶数量,防止内存溢出
      }
    }
  }
}
3. 使用别名与查询优化手段
通过索引别名隔离业务与底层索引变化,配合查询缓存、字段裁剪、只返回必要字段,进一步降低查询耗时与网络传输成本。
索引别名绑定脚本
POST /_aliases
{
  "actions": [
    {"add": {"index": "business-order-202609", "alias": "business-order-alias"}}
  ]
}
四、集群稳定与数据安全方案
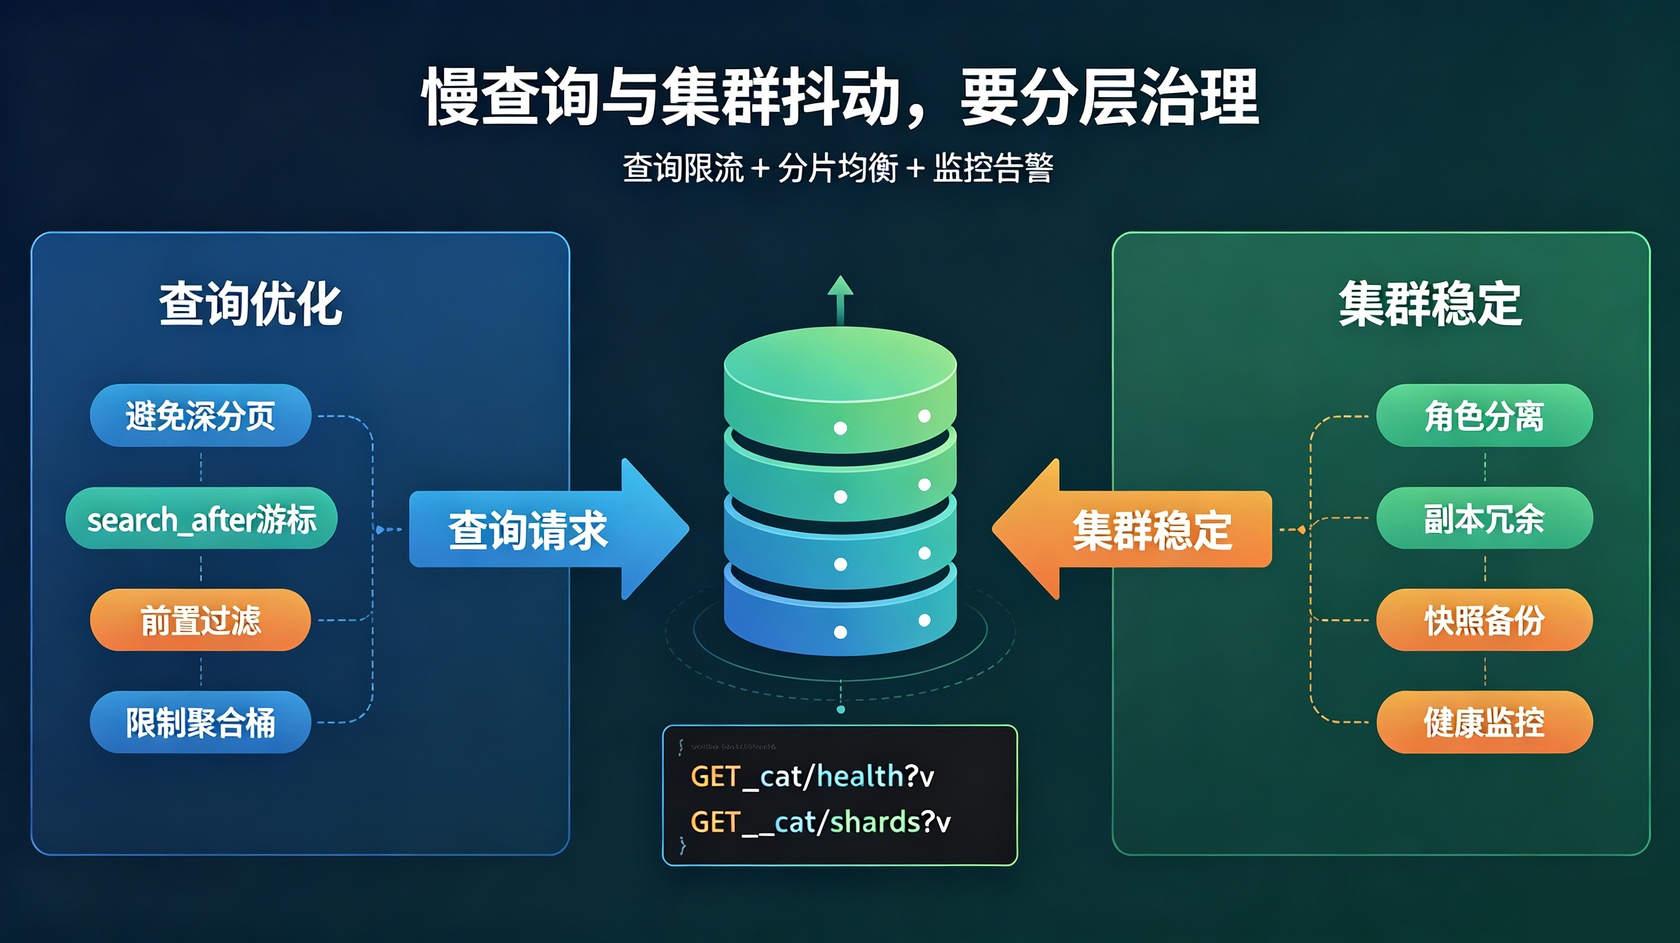
1. 合理配置节点与资源
分离主节点、数据节点与协调节点的职责,避免大节点承担过多角色;为 JVM 堆内存设置合理上限并预留系统内存,防止节点 OOM 抖动引发集群不稳定。
elasticsearch.yml 核心生产配置
# 节点角色分离
node.master: true
node.data: true
node.ingest: false

# 集群基础配置
cluster.name: es-production-cluster
network.host: 0.0.0.0
http.port: 9200

# 防止OOM核心配置
indices.memory.index_buffer_size: 15%
2. 保证副本冗余与数据安全
为重要索引设置合理的副本数,保证单个节点故障时有冗余可用;开启快照备份并定期执行,配合跨节点复制,防止数据永久丢失,做到可恢复、可回滚。
ES快照备份核心脚本
// 注册快照仓库
PUT /_snapshot/es-backup-repo
{
  "type": "fs",
  "settings": {
    "location": "/data/es-backup",
    "compress": true
  }
}

// 手动创建快照
PUT /_snapshot/es-backup-repo/snapshot_20260922?wait_for_completion=true
{
  "indices": "business-order-*",
  "ignore_unavailable": true
}
3. 监控集群健康与资源水位
持续监控集群状态(绿黄红)、分片健康、节点 CPU/内存/磁盘、查询延迟与拒绝率,设置告警阈值。发现节点变黄或变红第一时间排查,避免故障蔓延。
集群状态监控查询指令
# 查看集群整体健康状态
GET /_cat/health?v

# 查看索引分片分配情况
GET /_cat/shards?v

# 查看节点资源负载
GET /_cat/nodes?v
五、索引重建与数据迁移规范
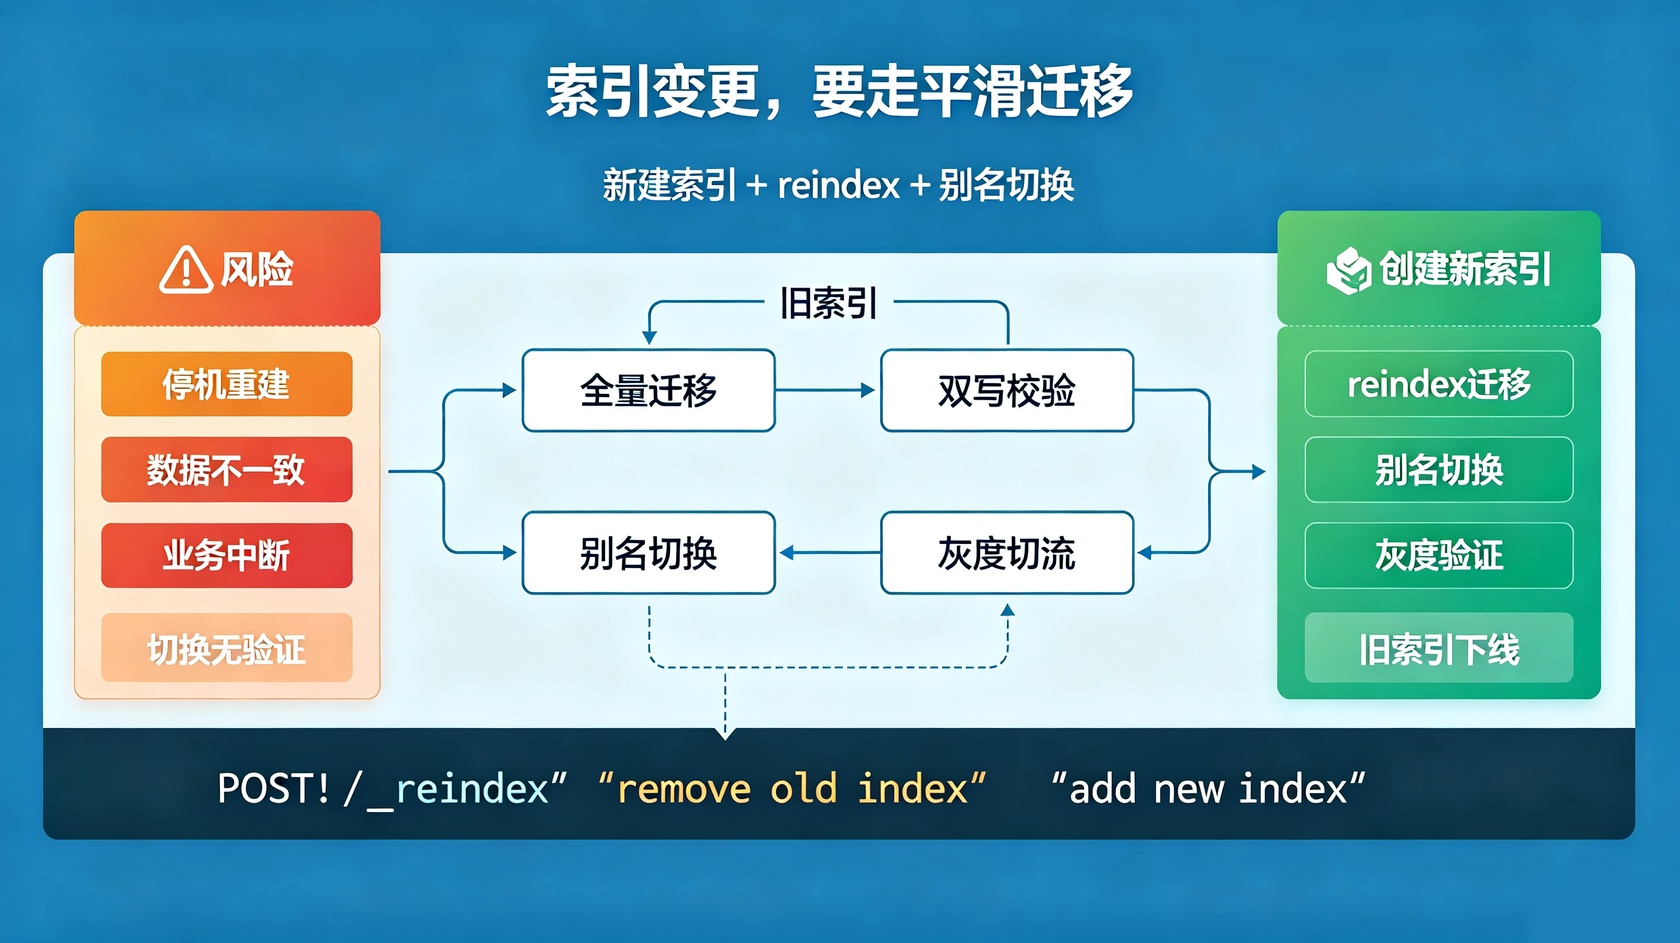
业务字段需要变更时,不要修改现有索引,而是基于新结构创建新索引,通过 reindex 将旧数据迁移到新索引;迁移期间用索引别名平滑切换流量,先切小比例验证查询结果与性能,再全量切换。整个过程保持别名不变、查询无感,切换前对数据量、耗时与结果做充分校验,确保业务连续、数据一致。
Reindex 平滑迁移完整代码
// 1. 创建新索引(新Mapping结构)
PUT /business-order-new
{
  "settings": {"number_of_shards": 3, "number_of_replicas": 1},
  "mappings": {
    "properties": {
      "order_id": {"type": "keyword"},
      "order_num": {"type": "keyword"},
      "user_id": {"type": "long"},
      "order_status": {"type": "integer"},
      "create_time": {"type": "date"}
    }
  }
}

// 2. 全量迁移旧索引数据到新索引
POST /_reindex
{
  "source": {"index": "business-order-old"},
  "dest": {"index": "business-order-new"}
}

// 3. 平滑切换别名,业务无感知切换
POST /_aliases
{
  "actions": [
    {"remove": {"index": "business-order-old", "alias": "business-order-alias"}},
    {"add": {"index": "business-order-new", "alias": "business-order-alias"}}
  ]
}
六、总结
Elasticsearch 生产故障,绝大多数不是搜索引擎本身的问题,而是对索引模型、Mapping 设计、查询机制和集群运维的理解不到位。核心原则可以归纳为:上线前用模板规范字段类型与分片,查询避免深分页并控制聚合范围,集群按职责分离节点并保证副本与快照冗余,索引变更走新建加别名平滑切换。配合本文全套可直接复用的实战代码,把规范落地,Elasticsearch 才能从"能检索"变成真正"稳、快、可用",支撑业务高效运行。

 在线
 电话
 微信
 需求
 TOP